Problema
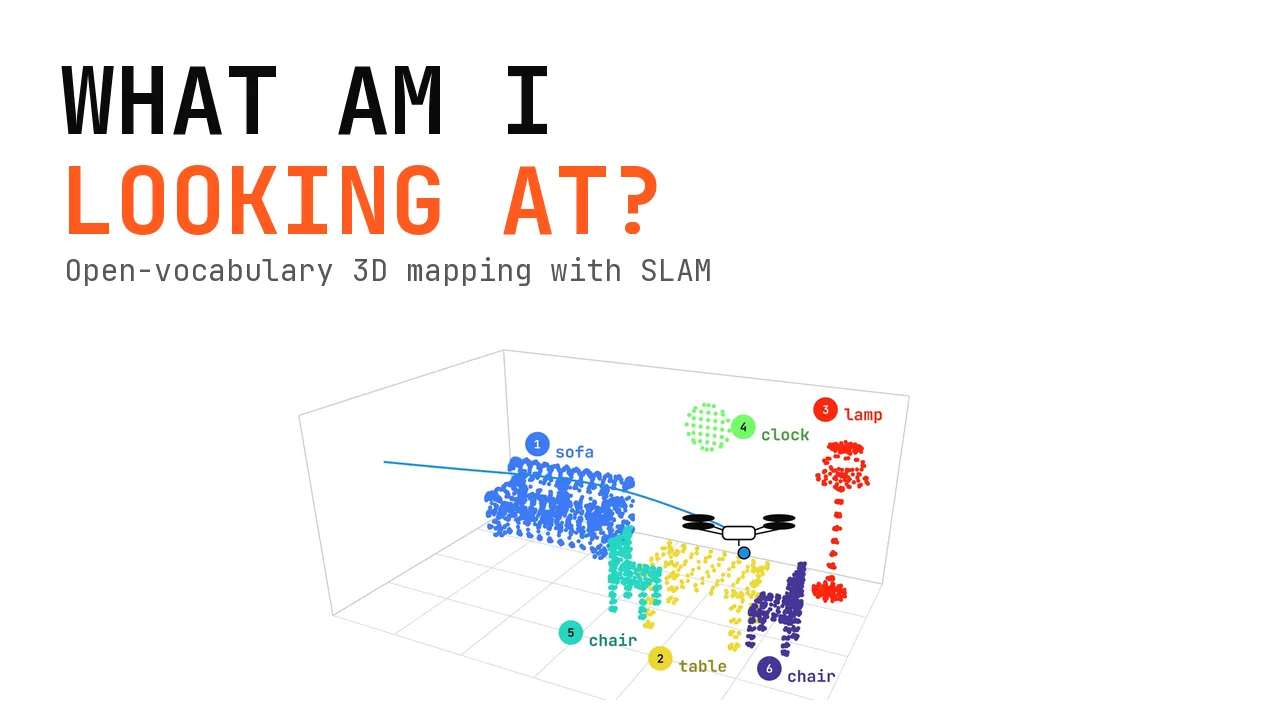
Un robot que recorre una casa, o cualquier otro espacio, necesita contestar dos preguntas. La primera, ¿dónde estoy?, la resuelve el SLAM desde hace años: con solo una cámara, calcula su posición mientras construye un mapa 3D. Pero ese mapa son puntos. Sirve para no chocar, no para obedecer «tráeme la taza de la mesa». Para el robot no hay tazas ni mesas, solo superficies.
La segunda es ¿qué estoy viendo? Contestar las dos a la vez es lo que hoy se llama inteligencia espacial. Los sistemas más nuevos agrupan los puntos en instancias, una por objeto, y le dan a cada una un significado.
OVO (Open-Vocabulary Online, Berriel Martins et al., RA-L 2025) es uno de ellos. Online, porque monta el mapa mientras la cámara se mueve, no después. De vocabulario abierto, porque no depende de una lista fija de objetos: el mapa se busca con palabras, y responde a «un sitio donde sentarse» o a «algo que da la hora».
Funciona notablemente bien. Pero en condiciones reales, los objetos no siempre se mantienen enteros. Uno se parte en dos. Dos se mezclan en uno. Y cuando el robot vuelve a un sitio que ya había visto, el mismo objeto aparece dos veces, una copia encima de la otra. Los propios autores reconocen que su fusión a veces deja escapar instancias que deberían unirse.
Las búsquedas, las etiquetas y cualquier tarea del robot trabajan sobre instancias. Si una está partida, mezclada o duplicada, el mapa responde mal aunque la geometría sea buena. Mi trabajo de fin de máster, dirigido por Javier Civera y Tomás Berriel, autores del artículo original de OVO, se centra en la consistencia de las instancias: encontrar en qué paso nace cada error y corregirlo ahí, sin perder lo que hace bueno a OVO.
Restricciones
- Los mismos modelos. Meter otra red que corra en cada fotograma rompe lo online. Las mejoras tenían que salir de lo que OVO ya calcula: las posiciones del SLAM, las máscaras del segmentador y los descriptores.
- Ganar sin perder. Cada cambio tenía que mejorar las instancias o hacer el sistema más rápido, sin empeorar lo otro. Unos mapas mejores a costa de un sistema más lento no valían.
- Medible y reproducible. Cada mejora se mide contra OVO tal cual, en las mismas escenas y con las mismas métricas. Y como una deriva real nunca se repite igual, hacía falta poder provocarla a voluntad para que la comparación fuera justa.
Enfoque
OVO solo recibe imágenes RGB-D: el color y, por cada píxel, a qué distancia está. Tiene dos partes. La geométrica es un SLAM (ORB-SLAM3 en este trabajo), que sitúa la cámara en cada momento y, con la profundidad, coloca los puntos del mapa. La semántica decide qué puntos van juntos y qué son:
- Un modelo de segmentación, SAM 2, mira un fotograma clave y recorta los objetos que ve. Son máscaras, en 2D.
- Los puntos del mapa se proyectan sobre ese fotograma. La máscara en la que caen los agrupa, y cada grupo es una instancia.
- Un modelo de visión y lenguaje, SigLIP (de la familia de CLIP), le da a cada instancia un descriptor: una especie de huella de su aspecto que se puede comparar con un texto.
Queda un detalle. La posición que calcula el SLAM se va desviando poco a poco: es la deriva. Al volver a un sitio conocido, el mapa recibe una segunda copia de lo que ya tenía. Cuando el SLAM reconoce el sitio, cierra el bucle (loop closure) y corrige el camino entero, y el mapa con él. Las dos copias quedan una encima de la otra, y una fusión comprueba si son el mismo objeto para unirlas.
Mi trabajo empezó por ver y medir. Construí un visor con Rerun que rebobina la construcción del mapa fotograma a fotograma, con las máscaras y las proyecciones de cada uno: así se sigue un error hasta el instante en que nace. Y un banco de pruebas: una variante del SLAM que provoca a voluntad un salto de posición y su cierre de bucle, idénticos en cada ejecución, y que puntúa cada decisión de fusión contra la realidad. Con las dos herramientas, cada error apuntaba a un paso concreto. De ahí salieron tres mejoras:
- Geometría sincronizada con el SLAM. OVO solo corregía sus puntos en el cierre de bucle. Pero el SLAM hace más: con cada vista nueva, refina las posiciones que ya había estimado (el bundle adjustment local). OVO nunca usaba esas correcciones, así que cada vista nueva se proyectaba sobre un mapa un poco equivocado, y el error se colaba en todas las decisiones siguientes. Ahora, cada vez que el SLAM corrige una posición, los puntos vistos desde ella se mueven con ella, justo antes de cada paso semántico.
- Asignación por evidencia. En OVO, el dueño de cada punto lo decide una sola máscara, la primera, y nunca se revisa. Y las máscaras se equivocan: una sola puede cubrir una pantalla, una mesa y una silla, y las tres acaban siendo una instancia. Pero la evidencia está ahí. Cada vista nueva proyecta los puntos sobre sus máscaras, y se ve qué máscara reclama puntos que ya tienen otro dueño. Por eso construí el contest, un mecanismo que decide si dos instancias deben unirse, separarse o quedarse como están, a partir de la evidencia observada a lo largo del tiempo. Funciona como una disputa: la máscara que reclama puntos de otra instancia es la challenger, y la instancia que ya los tenía, la defender. Cada vista que repite esa reclamación suma evidencia. Esa evidencia se resume en tres señales: contención (cuánto de la defender se lleva la challenger), confianza (si lo reclama siempre o solo a ratos) y exclusividad (si está sola o se pelean varias por los mismos puntos). Con las tres, el contest toma su decisión.
- Fusión por vóxeles. Para encontrar los duplicados, OVO comparaba todos los pares de instancias con tres filtros seguidos: si sus centros están cerca, si sus descriptores se parecen y, el más caro, si sus puntos ocupan de verdad el mismo espacio. Ese último se llevaba el 87 % del tiempo de la fusión. Lo sustituí por una rejilla de vóxeles compartida: el espacio se divide en cubos pequeños, y cada instancia pasa a ser el conjunto de cubos que ocupa. Dos instancias solo pueden solaparse si comparten algún cubo, así que solo esos pares se comparan, y medir el solape es contar cubos comunes. Con el solape resuelto por la rejilla, a la fusión solo le queda una pregunta, la semántica: ¿dicen sus descriptores que es el mismo objeto?
Resultado
Lo medí en dos conjuntos de datos muy distintos. Replica, con ocho escenas sintéticas, profundidad limpia y un segmentador que lo cubre casi todo. Y ScanNet, una escena real, con ruido, deriva continua y un segmentador que deja la mitad de cada imagen sin máscara. En ScanNet, cada cifra es la media de cinco ejecuciones.
- Geometría sincronizada con el SLAM: en la escena real, la precisión semántica del mapa sube un 18 % (mIoU de 32,4 a 38,3). Son unos 200 refrescos por escena, y cuestan menos de un segundo en total.
- Asignación por evidencia: en Replica, mejores instancias en las ocho escenas, sin que ninguna empeore. Hasta un 18,6 % más, y entre un 1,5 % y un 7,1 % en las cuatro que no se usaron para ajustarla. Sin coste de tiempo: 998 segundos frente a 1002.
- Fusión por vóxeles: en la escena real, de más de 15.000 pares comparados a unos 500, y de 3 a 0,6 segundos. Cinco veces más rápida, con la misma calidad. En el banco de pruebas, más de veinte veces más rápida, y con la mejor calidad de todo el estudio.
Las tres mejoras trabajan juntas. Con ellas, el mapa es más preciso, los objetos se mantienen enteros y la fusión deja de ser el cuello de botella. El límite ya no está en cómo se monta el mapa, sino en lo que le llega: la posición que da el SLAM y lo que ve el segmentador.
Un mapa más coherente, una fusión cinco veces más rápida y el siguiente límite, localizado.
Stack y entregables
- Análisis de OVO Sus puntos débiles, uno a uno: los que quedan corregidos y los que siguen abiertos.
- Visor en Rerun Rebobina la construcción del mapa, con las máscaras y las proyecciones de cada fotograma.
- Banco de pruebas Deriva y cierre de bucle a voluntad, idénticos en cada ejecución, y cada fusión puntuada.
- Geometría sincronizada con el SLAM Los puntos del mapa siguen cada corrección del SLAM.
- Contest Revisa el dueño de cada punto con la evidencia que se acumula.
- Fusión por vóxeles Solo compara lo que comparte espacio.
Dónde encaja esto
Robots, drones y sistemas de inspección necesitan cada vez más que un mapa: saber qué objetos hay en él y encontrarlos cuando se les pide. Los sistemas que lo hacen salen de la investigación y avanzan muy rápido, pero están pensados para escenas limpias. En un almacén, una planta o una obra hay ruido, la cámara es peor y aparece lo que el modelo nunca vio. Ahí es donde fallan, y un modelo más grande no siempre lo arregla.
Mi trabajo empieza justo ahí. Analizo el sistema por dentro hasta encontrar dónde y por qué falla, propongo cómo corregirlo y lo resuelvo en el paso donde nace, sin perder lo que ya hacía bien. Y en sistemas tan encadenados, lo que más rinde no suele ser un modelo nuevo, sino optimizar el que ya hay: más calidad con los mismos modelos, o la misma calidad en una fracción del tiempo.