Problema
En Zaragoza está uno de los grupos de SLAM más respetados del mundo: el de Montiel y Tardós, la gente detrás de ORB-SLAM. Hace tiempo que su reto no es que un robot se oriente en un pasillo, sino algo bastante más difícil: orientarse dentro de un cuerpo humano.
La idea es potente. Si el endoscopio construye un mapa 3D del colon mientras avanza, el médico puede saber qué zonas le quedan por revisar o medir un pólipo en directo.
El problema es que un colon es casi el peor escenario posible para un SLAM. Hay poca luz, y la que hay rebota. Las paredes son lisas y sin textura, así que hay pocos puntos a los que agarrarse. Todo se deforma: durante la exploración y de una colonoscopia a otra. Y por si fuera poco, agua, desenfoque e instrumental se cruzan delante de la cámara.
Para eso el grupo creó CudaSIFT-SLAM, el primer SLAM capaz de recorrer una colonoscopia completa en tiempo real, acelerado por GPU. Aun así, ahí dentro perderse es inevitable. Y cada vez que se pierde, empieza un mapa desde cero: el mismo colon acaba troceado en varios mapas sueltos.
Para coserlos, y para corregir el error acumulado cuando vuelve a pasar por un sitio (el cierre de bucle), el sistema necesita contestar una pregunta una y otra vez: ¿ya he estado aquí? Eso es el reconocimiento de lugares. Y en un colon es justo la pieza que más sufre.
Restricciones
- No romper lo que funciona. CudaSIFT-SLAM ya era un sistema serio. La pieza nueva tenía que encajar en su sitio, sin rehacer nada alrededor.
- Tiempo real, sin excusas. Cada fotograma clave nuevo lanza una consulta. Si la consulta tarda, el SLAM entero se retrasa.
- De Python a C++. La red estaba entrenada en PyTorch y el SLAM está escrito en C++. Había que llevarla de un mundo a otro sin que cambiara su respuesta.
Enfoque
Cuando llega un fotograma clave nuevo, el SLAM lo compara con todos los que tiene guardados, de todos los mapas, y se queda con los más parecidos como candidatos. CudaSIFT-SLAM lo hacía con Bag of Words: describe cada imagen contando qué «palabras visuales» contiene (patrones de puntos característicos), como quien resume un libro por las palabras que más repite. Funciona muy bien en una calle o una oficina. En un colon, con tan pocos puntos y tan poco fiables, se queda corto.
Los candidatos, por sí solos, no deciden nada. La última palabra la tiene un filtro geométrico: empareja puntos entre el fotograma nuevo, el candidato y sus dos vecinos, y comprueba en 3D que todo encaja. Si pasa, los mapas se unen.
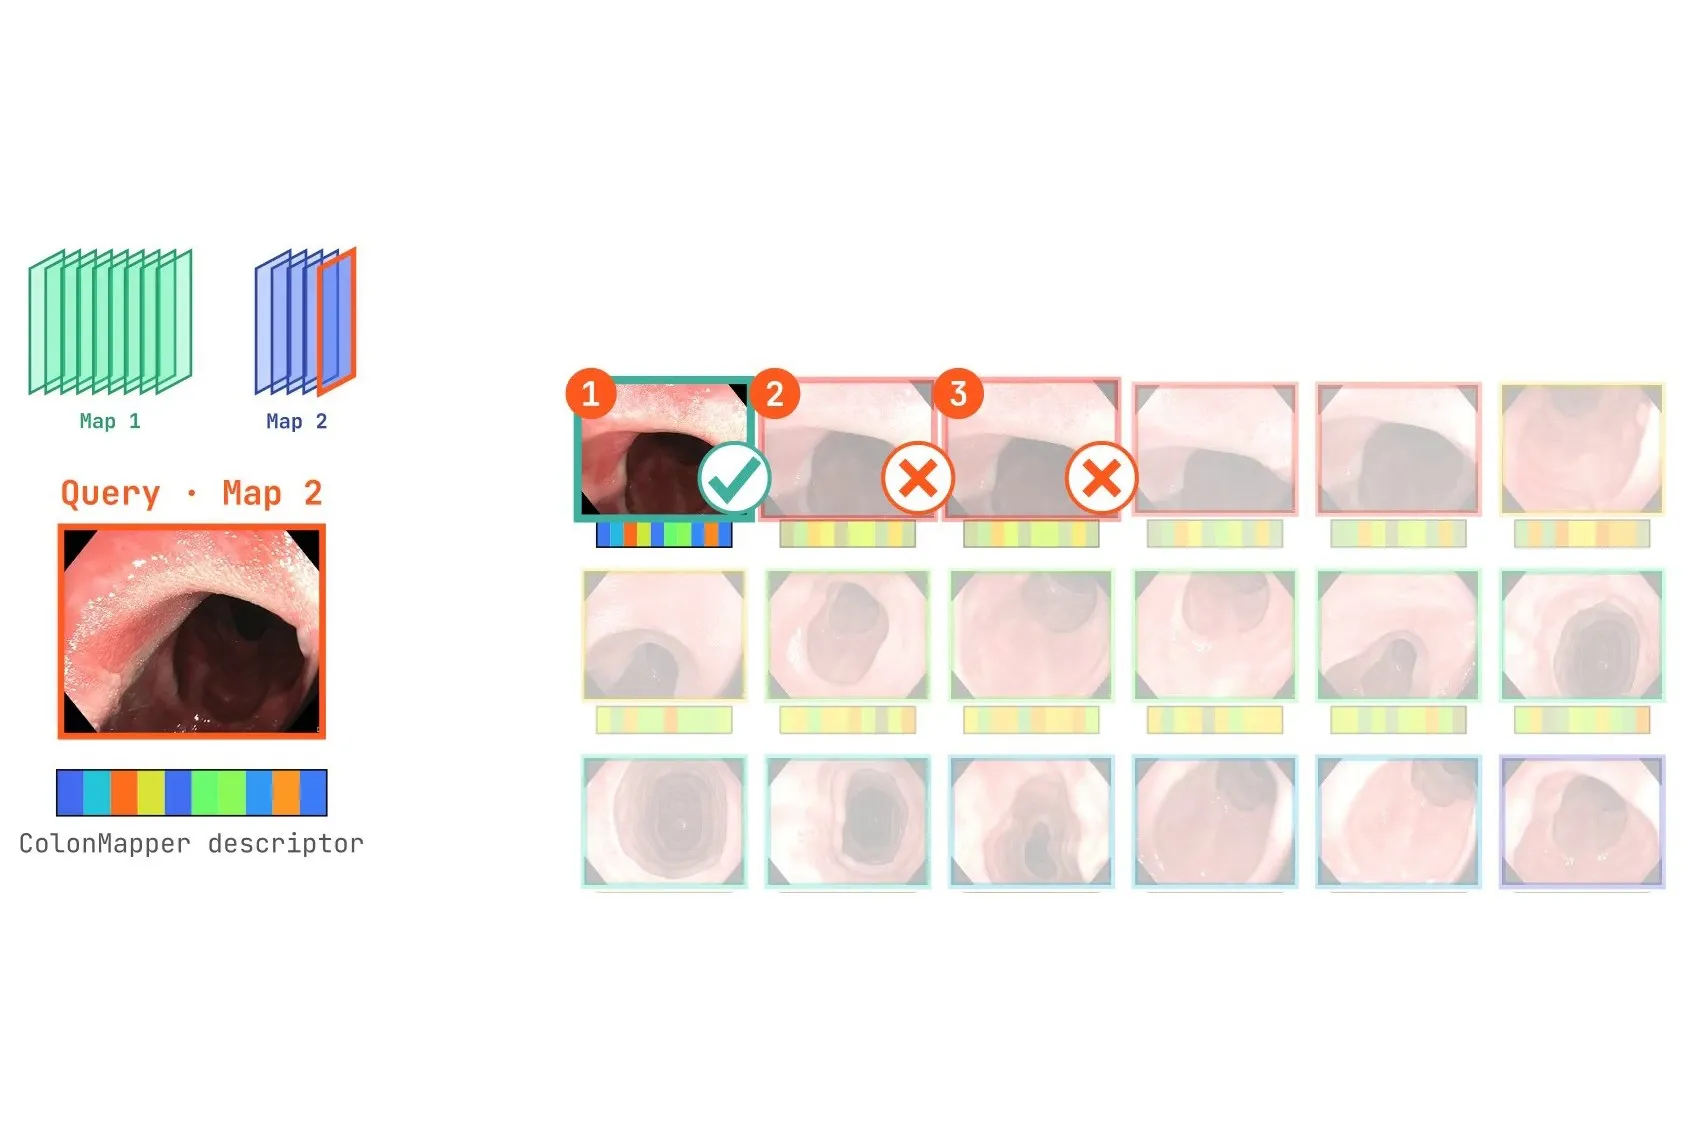
Mi trabajo fue cambiar la pieza que hace la pregunta. En el mismo grupo se había desarrollado ColonMapper (Morlana et al.), una red entrenada con colonoscopias reales para reconocer sitios del colon incluso cuando la escena cambia mucho, por ejemplo entre dos colonoscopias del mismo paciente. Su clave es un descriptor global: la red resume cada imagen en un único vector, y sitios parecidos dan vectores parecidos.
La idea: sacar ese descriptor de la red y ponerlo en el lugar de Bag of Words, dentro de CudaSIFT-SLAM. Un reconocimiento de lugares aprendido con deep learning, hecho a medida para este problema.
En la práctica, fueron tres pasos:
- Llevar la red a C++. La exporté de PyTorch a TorchScript y escribí una librería con LibTorch y OpenCV: recibe una imagen, la pasa por la red en GPU y devuelve su vector.
- Hacerla convivir con el SLAM. Aquí estaba lo difícil. CudaSIFT-SLAM ya usa CUDA para extraer y emparejar sus puntos SIFT, y la red trae el suyo: había que conseguir que los dos convivieran sin pisarse. Además, el SLAM reparte el trabajo en tres hilos que corren a la vez (seguimiento, mapeado y unión de mapas), y la red tenía que encajar en ese reparto sin frenar a ninguno.
- Cambiar quién propone los candidatos. Cada keyframe calcula su descriptor al crearse y lo guarda. Cuando el SLAM lanza una consulta, compara el keyframe nuevo con todos los guardados y se queda con los más parecidos. Esos candidatos pasan por el mismo filtro geométrico de siempre, tanto para unir mapas como para cerrar bucles.
Resultado
ColonMapper quedó integrado y funcionando dentro del SLAM, tanto en la unión de mapas como en el cierre de bucle. En las métricas globales rinde a la par que Bag of Words. La diferencia está en los candidatos: los de ColonMapper son más consistentes, mientras que Bag of Words salta de un sitio a otro del colon.
Un ejemplo real de la evaluación: la misma consulta y los cinco mejores candidatos de cada método.
Con mejores candidatos, la responsabilidad se desplazó. Ya no fallaba la pieza que reconoce el sitio visitado con anterioridad, sino la que lo confirma: el filtro geométrico necesita puntos 3D en común con el candidato, y en un colon la nube es tan escasa que descartaba muchos correctos. El problema pasó de ser de reconocimiento a ser geométrico.
Stack y entregables
- Librería en C++ Ejecuta ColonMapper en GPU y devuelve el descriptor de cada imagen.
- Integración en el SLAM Dentro de CudaSIFT-SLAM, en la unión de mapas y en el cierre de bucle.
- Evaluación ColonMapper frente a Bag of Words, consulta a consulta.
C++ · LibTorch (TorchScript) · OpenCV · CUDA · CMake
Imágenes: C3VD (Bobrow et al., Johns Hopkins), CC BY-NC-SA 4.0.
Dónde encaja esto
Es un problema que se repite en cualquier sistema de visión que ya funciona: hay un modelo nuevo, entrenado en Python, que promete hacerlo mejor, pero el sistema está en C++, corre en tiempo real y no se puede parar para rehacerlo.
Ese salto es lo que hago: llevar el modelo al sistema sin romper lo que ya funciona, medirlo contra lo que había y decir con datos dónde está el siguiente límite. Y elegir la herramienta adecuada para cada caso: LibTorch cuando basta con llevar el modelo a C++, TensorRT cuando hay que exprimir cada milisegundo de GPU.